Saya Dapat Berapa Token ?
Untuk mendapatkan estimasi jumlah token, perhitungannya cukup kompleks dan dipengaruhi banyak faktor. Baca tulisan ini sampai selesai mengingat kami mau mengedepankan tranparansi.
Pada Token Plan maupun PAYG, appverse.id tidak pernah melakukan markup atau menerapkan mekanisme multiplier token.
Berikut adalah beberapa faktor yang bisa mempengaruhi jumlah konsumsi token per paket, dan seharusnya ini berlaku dimanapun Anda menggunakan AI :
Jenis agent yang digunakan. Contoh paling sederhana dari faktor agent adalah implementasi system prompt oleh agent itu sendiri. Setiap agent memiliki system prompt yang berbeda-beda. Contohnya system prompt Pi jauh lebih pendek daripada OpenCode. Namun, OpenCode sendiri memiliki reputasi cache hit lebih tinggi (yang mana ujungnya akan menghemat token juga).
Besar project yang dikerjakan. Project dengan beberapa file kecil tentunya menghabiskan token yang lebih sedikit. Project yang lebih besar sebaliknya.
Persentase cace hit atau biasa disebut cache hit ratio. Cache hit ditentukan oleh system prompt dari agent maupun dari aktivitas yang dilakukan. Contohnya, agent harness zcode memiliki cache hit ratio paling tinggi, sedangkan opencode di urutan kedua dan seterusnya (silahkan searching saja). Cache hit ini cukup sulit diprediksi namun cukup bisa diusahakan.
Mengenai cache hit, terdapat beberapa skenario yang menyebabkan rasio cache hit rendah diantaranya adalah :
Menggunakan 9router, terutama ketika banyak provider tersambung dan menggunakan combo apalagi mengaktifkan round robin.
Banyak jeda diantara coding, misal Anda coding intens di jam 01:00 - 02:00 (intens, banyak terkena cache hit) -> kemudian Anda jeda -> lanjut coding lagi jam 04:00 - 05:00 . Ketika Anda lanjut vibe coding lagi di jam 4 itu maka kemungkinan besar akan terkenca cache miss (tidak kena cache hit). Hal ini dikarenakan provider AI ataupun penyedia AI Gateway hanya menerapkan cache duration sekian menit saja, misal 10 menit - 1 jam.
Sering gonta-ganti model ditengah sesi.
Selain hal di atas, masih banyak skenario lainnya yang tidak mungkin saya tulis satu - per - satu.
Bahasa yang digunakan, prompting dengan bahasa inggris jauh lebih hemat token dibanding prompting dengan bahasa indonesia.
Rasio Input / Output token, hal ini sulit dikontrol karena memang kebutuhan input output token menyesuaikan task yang sedang dikerjakan.
Selain beberapa hal di atas, masih banyak faktor lainnya yang tidak mungkin saya jelaskan semua. Perhatikan gambar di bawah :
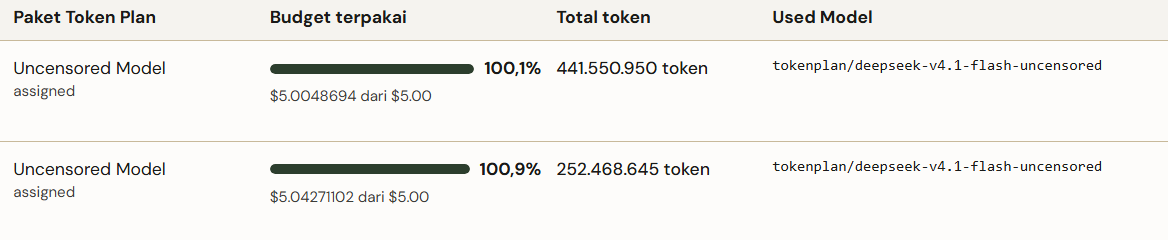
Gambar di atas adalah sampling real milik customer appverse.id yang membeli paket uncensored dengan akses model : ds v4.1 flash uncensored, glm 5.3 flash uncensored, glm 5.3 uncensored namun kedua user tersebut menggunakan 1 model yang sama yaitu ds v4.1 flash uncensored. Saya mengambil data ini supaya mudah perbandingannya (tidak lintas model). Kedua user tersebut menggunakan paket yang sama : Uncensored Model (5 USD), dan sama-sama hanya mengakses model ds v4.1-flash uncensored dari awal menggunakan paket Uncensored sampai kuota habis. Keduanya tidak berganti-model.
Pada user pertama, jumlah tokennya mencapat 441 jt token, sedangkan contoh user kedua hanya 250 jt token. Ini adalah contoh betapa dinamisnya penggunaan token per 5 usd. Karena bisa dipengaruhi oleh banyak faktor, bisa jadi di user ke dua dipasang di 9router sehingga tidak optimal, bisa jadi di user ke dua terlalu banyak jeda coding sehingga cache hit tidak kena.
Yang jelas, sejauh ini di Appverse.id tidak menerapkan mekanisme peak hour pricing, artinya kapanpun waktu kamu menggunakan model maka akan sama harga nya. Kita juga tidak melakukan markup, satu-satunya keuntungan adalah biaya transaksinya saja.